
Você recebeu três textos de ferramentas diferentes. Um parece mais criativo, outro é mais organizado e o terceiro chegou primeiro. Qual vale levar para a rotina do negócio? A resposta exige olhar além da primeira impressão. Um teste pequeno, com critérios definidos antes de ver os resultados, permite comparar precisão, trabalho de correção e comportamento diante de informações ausentes. A proposta deste guia é montar essa avaliação sem depender de programação nem transformar preferência pessoal em suposta prova técnica.
Prepare uma prova que represente seu trabalho
Escolha uma entrega recorrente e suficientemente delimitada. Para um freelancer de sites, pode ser transformar um briefing comercial em uma apresentação de serviço. Para uma equipe de marketing, preparar variações de uma mensagem aprovada. Avaliar dez tipos de trabalho de uma vez dificulta descobrir por que uma ferramenta foi bem ou mal.
Monte seis casos iniciais: três pedidos comuns, dois com informações incompletas e um com instruções que exigem atenção especial. Essa quantidade é uma sugestão operacional para começar, não uma amostra estatisticamente representativa. Depois, acrescente os problemas encontrados na rotina. O teste precisa evoluir junto com o uso.
Em cada caso, guarde o material de entrada, os fatos que devem aparecer e o que não pode ser inventado. Use dados fictícios que reproduzam dificuldades reais, materiais públicos ou informações cujo uso esteja autorizado. Um exemplo inventado pode ser válido para avaliar uma condição específica; o importante é não confundi-lo com evidência de desempenho no trabalho real.
As boas práticas de avaliação da OpenAI recomendam testes ligados à tarefa, casos variados e avaliação contínua. Embora a documentação trate de aplicações técnicas, o princípio pode ser adaptado a uma comparação manual. Não é preciso contratar uma API para aplicar uma ficha de avaliação.
Escreva também uma resposta de referência ou uma lista de requisitos, preparada por quem conhece o serviço. Ela não deve impor uma redação única. Seu papel é distinguir uma escolha de estilo aceitável de um erro factual, uma omissão importante ou uma promessa indevida.
Defina notas e motivos de reprovação antes de começar
Adote uma escala simples de zero a dois em quatro dimensões. Em precisão, dois significa preservar todos os fatos; um, apresentar ambiguidade corrigível; zero, contradizer ou inventar informação. Em cobertura, observe se o texto contém o que o leitor precisa saber. Em formato, confira tamanho e organização. Em clareza, avalie se alguém de fora entende o próximo passo.
Escreva exemplos para cada nota. “Texto bom” permite interpretações demais. “Explica como solicitar contato e preserva a condição de que o prazo depende do escopo” oferece um critério observável. A documentação de avaliações da Anthropic também orienta a definir critérios específicos, mensuráveis e relevantes.
Uma ponderação ilustrativa seria dar peso três para precisão, dois para cobertura, um para formato e um para clareza. A pontuação máxima seria 14: dois pontos multiplicados pela soma dos pesos. Esses pesos servem ao exemplo e precisam refletir sua prioridade; não são uma classificação oficial de ferramentas.
Defina, em separado, falhas que impedem a aprovação daquela saída. Em uma comunicação comercial, inventar garantia, preço ou prazo pode ser motivo suficiente. Em uma tarefa administrativa de profissão regulamentada, oferecer orientação técnica individualizada fora do escopo também pode inviabilizar o uso. A média não deve esconder uma ocorrência com consequência importante.
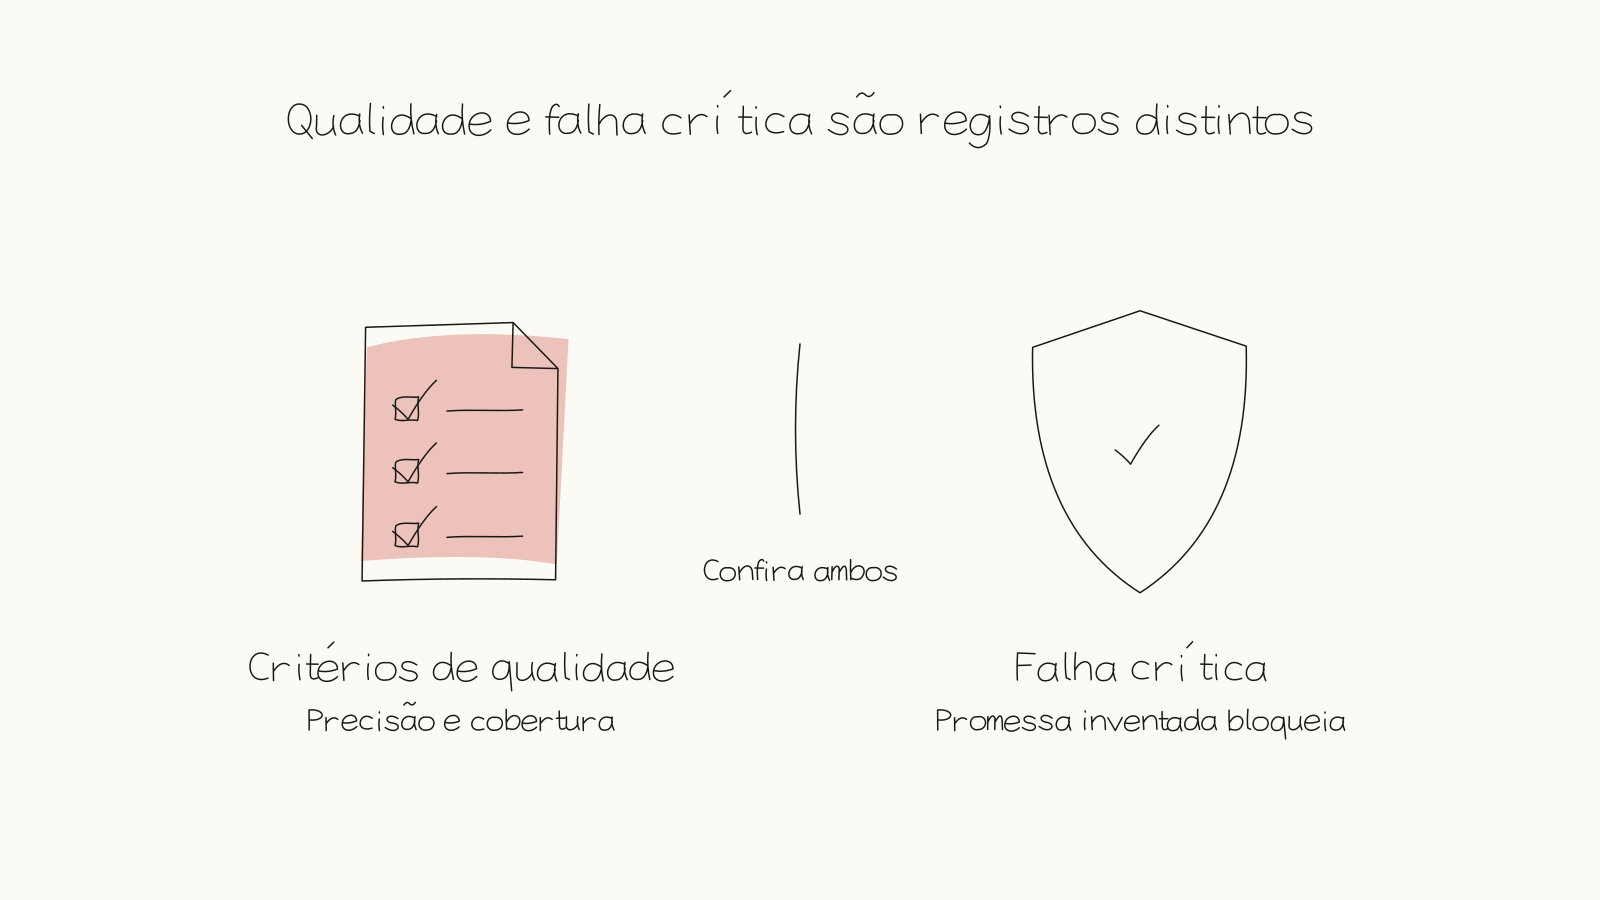
- Nota de qualidade: mede quanto a saída atende aos critérios escolhidos.
- Falha crítica: registra um erro que exige interromper o uso daquela versão.
- Tempo de revisão: informa quantos minutos foram necessários para aprovar a entrega.
- Observação: descreve o problema concreto, sem rótulos como “IA ruim”.
Quando duas pessoas revisarem, peça que pontuem primeiro de forma independente. Depois discutam divergências usando trechos específicos. Se uma dá dois em precisão e outra dá zero, talvez a ficha esteja vaga ou exista uma informação que precisa de confirmação antes de continuar.
Execute a comparação sem mudar as regras no meio
Registre ferramenta, plano, modelo quando identificável, data e recursos habilitados. Pesquisa na internet, arquivos de referência, memória e instruções personalizadas podem modificar a experiência. Não apresente como comparação equivalente um teste em que só uma opção recebeu materiais extras.
Para avaliar redação sobre fatos fornecidos, use o mesmo briefing, uma conversa nova e o mesmo limite de correções em todas as opções. Para avaliar pesquisa, prepare outro conjunto de casos e permita pesquisa de maneira equivalente. Misturar as duas modalidades deixa incerto se você está comparando escrita, busca ou acesso a documentos.
Reserve dois casos adicionais para depois dos ajustes. Se você melhorar o briefing olhando apenas os exemplos já conhecidos, pode produzir um resultado que funciona naquela pequena prova e falha em pedidos novos. Os casos reservados ajudam a perceber essa diferença.
Guarde a primeira resposta antes de pedir ajustes. Em seguida, use uma correção padronizada, como “preserve os fatos, remova informações não fornecidas e mantenha o tamanho solicitado”. Se o operador precisar explicar algo adicional, registre o acréscimo e aplique a mesma condição às demais candidatas quando fizer sentido.
Identifique as respostas como A, B e C durante a leitura. Isso reduz a influência da marca, embora não elimine toda preferência. Alterne a ordem de avaliação, porque o primeiro texto pode acabar funcionando como referência involuntária para os seguintes.
Repita os casos mais importantes em outra rodada. A mesma entrada pode produzir respostas diferentes. Se uma ferramenta acertar em uma tentativa e inventar um prazo na seguinte, registre a variação; escolher apenas a melhor resposta cria um retrato otimista demais. Esta proposta de teste é baseada em documentação e método editorial, sem experimento comparativo realizado para este artigo.
Veja como uma nota alta pode esconder uma escolha ruim
Considere um caso inteiramente hipotético. Uma agência precisa de uma apresentação com até 120 palavras sobre a criação de sites. O briefing confirma levantamento de necessidades, organização das páginas e revisão com o cliente. Não informa preço nem prazo. A entrega deve terminar convidando a pessoa a descrever seu projeto.
A resposta A explica as etapas com clareza, mas acrescenta “site pronto em sete dias”. Pela ficha, recebe zero em precisão, dois em cobertura, dois em formato e dois em clareza: oito de 14 pontos. Além disso, incorre na falha crítica de inventar prazo. Corrigir essa promessa é obrigatório, mesmo que a redação agrade mais.
A resposta B preserva os fatos e cabe no limite, mas omite a revisão com o cliente. Recebe dois em precisão, um em cobertura, dois em formato e dois em clareza: 12 de 14. O editor leva quatro minutos para completar o ponto ausente e conferir novamente o briefing.
A resposta C mantém todas as etapas e nenhum fato inventado, porém excede o limite e dificulta o próximo passo com frases longas. Com dois em precisão, dois em cobertura, zero em formato e um em clareza, chega a 11 de 14. A edição leva oito minutos.
Esses números não representam produtos reais. Servem para mostrar que decisão e pontuação são coisas relacionadas, mas diferentes. B seria a candidata mais promissora nesse caso. Ainda seria necessário observar os outros testes, a repetibilidade e os requisitos de privacidade antes de adotá-la.
Imagine que A melhore muito na segunda rodada, mas continue inventando condições em dois casos incompletos. Essa informação vale mais que a média geral. Você pode descartá-la para propostas e, separadamente, avaliar se existe outro uso de baixo risco em que seu desempenho compense.
As notas aplicam pesos de três, dois, um e um aos quatro critérios. A tabela ilustra o método, sem classificar ferramentas reais.
Não foi possível carregar a tabela, execute um comando para corrigir a tabela.
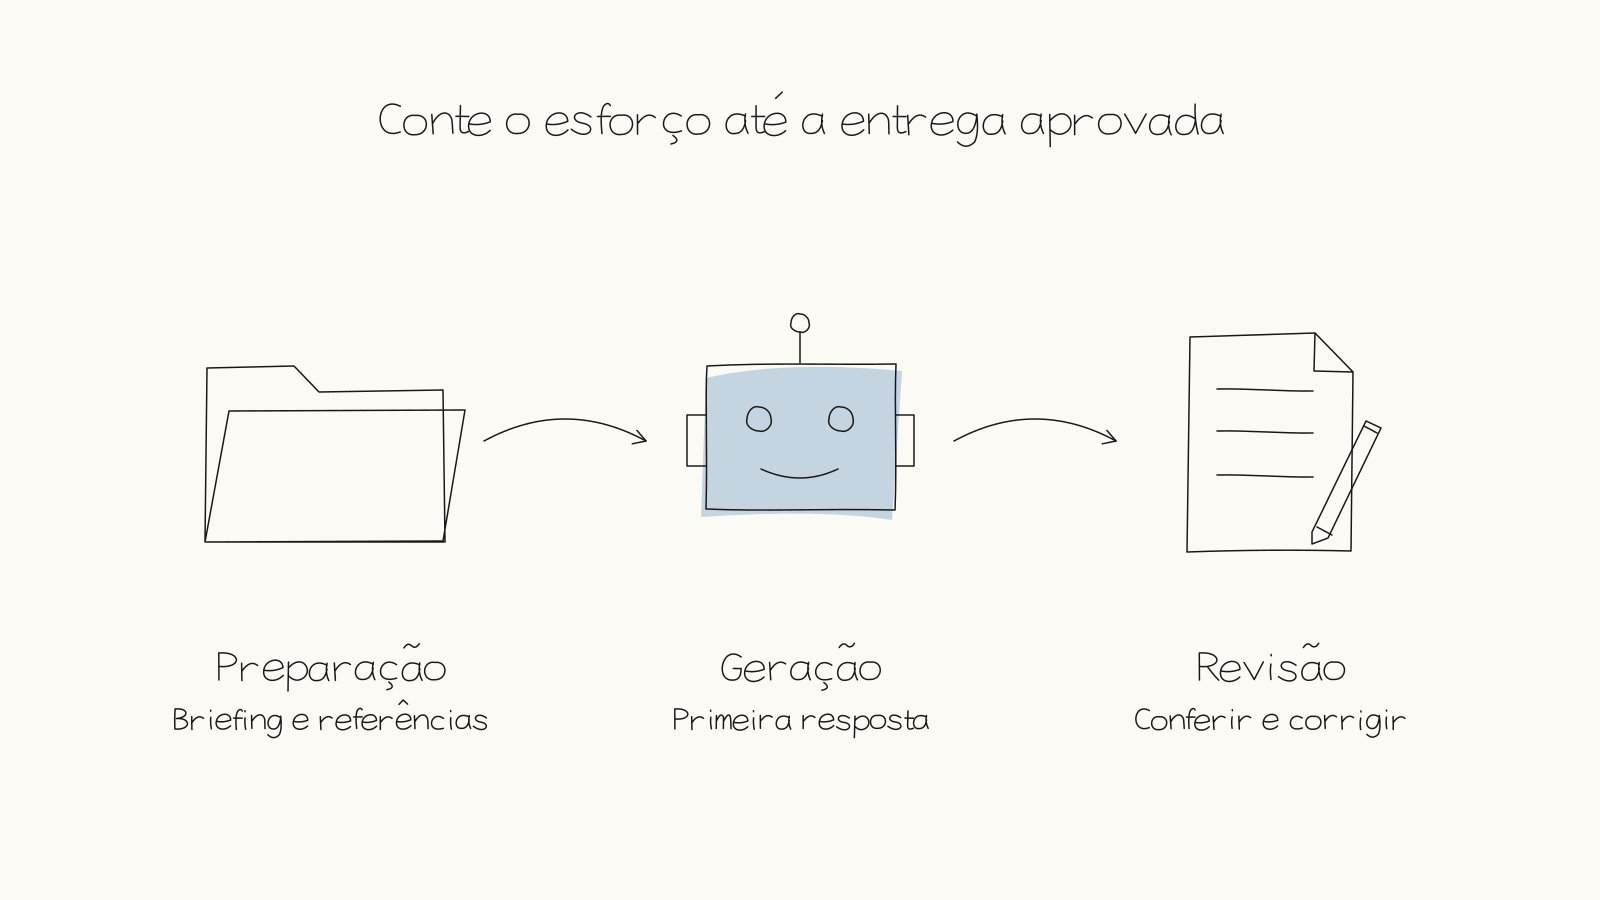
Guarde um exemplo de texto produzido sem IA nas mesmas condições de qualidade, para comparar o esforço total do processo. Inclua preparação, pesquisa, redação e aprovação nos dois caminhos, usando tarefas de complexidade semelhante. Se a preparação do briefing e a conferência consumirem mais tempo que a tarefa anterior, a adoção pode precisar de outro recorte. O resultado útil não é demonstrar que uma IA venceu outra, mas verificar se a nova rotina melhora uma entrega que o negócio realmente precisa concluir.
Escolha pelo conjunto de entregas aprovadas
Ao consolidar os resultados, conte quantas saídas ficaram utilizáveis, quantas exigiram reconstrução e em quais apareceram falhas críticas. Some os minutos de preparação e revisão, além do tempo de geração. Uma resposta rápida que exige vinte minutos de conferência não necessariamente economiza trabalho.
Não tire conclusões definitivas de diferenças pequenas. Se duas opções apresentam qualidade semelhante em seis casos, a familiaridade da equipe, a organização dos arquivos e os controles disponíveis podem decidir o piloto. Amplie o teste quando a escolha tiver custo alto ou afetar tarefas mais sensíveis.
Privacidade e contratação devem passar por uma verificação própria. A nota editorial não avalia retenção de dados, permissões, uso para treinamento nem condições comerciais. Antes de usar informações confidenciais, examine a conta e o contexto de uso com os responsáveis adequados.
Registre uma decisão específica: “Adotar esta ferramenta para rascunhos de páginas comerciais, com revisão humana e sem documentos de clientes no piloto”. Isso orienta melhor a equipe que dizer “esta é a melhor IA”. Defina também o que motivará um novo teste, como mudança de modelo, piora observada ou uma nova tarefa.
Guarde os casos, as respostas e a ficha. Quando surgir uma atualização, você terá um ponto de comparação. A escolha deixa de depender de entusiasmo com novidades e passa a responder uma pergunta verificável: qual ferramenta permite concluir este trabalho com qualidade e esforço aceitáveis?
